投机解码的 KV 流转:prefill 阶段 DFlash 也要吃下整个 prompt
最近在理投机解码里 target 和 DFlash 的关系,卡在一个问题上:我们关注 target 和 DFlash 在 prefill 阶段和 decode 阶段的 KV,是不是即使是 prefill 阶段,也要全部灌到 DFlash 里,保证 DFlash 也得根据 prompt 生成自己的 KV Cache?
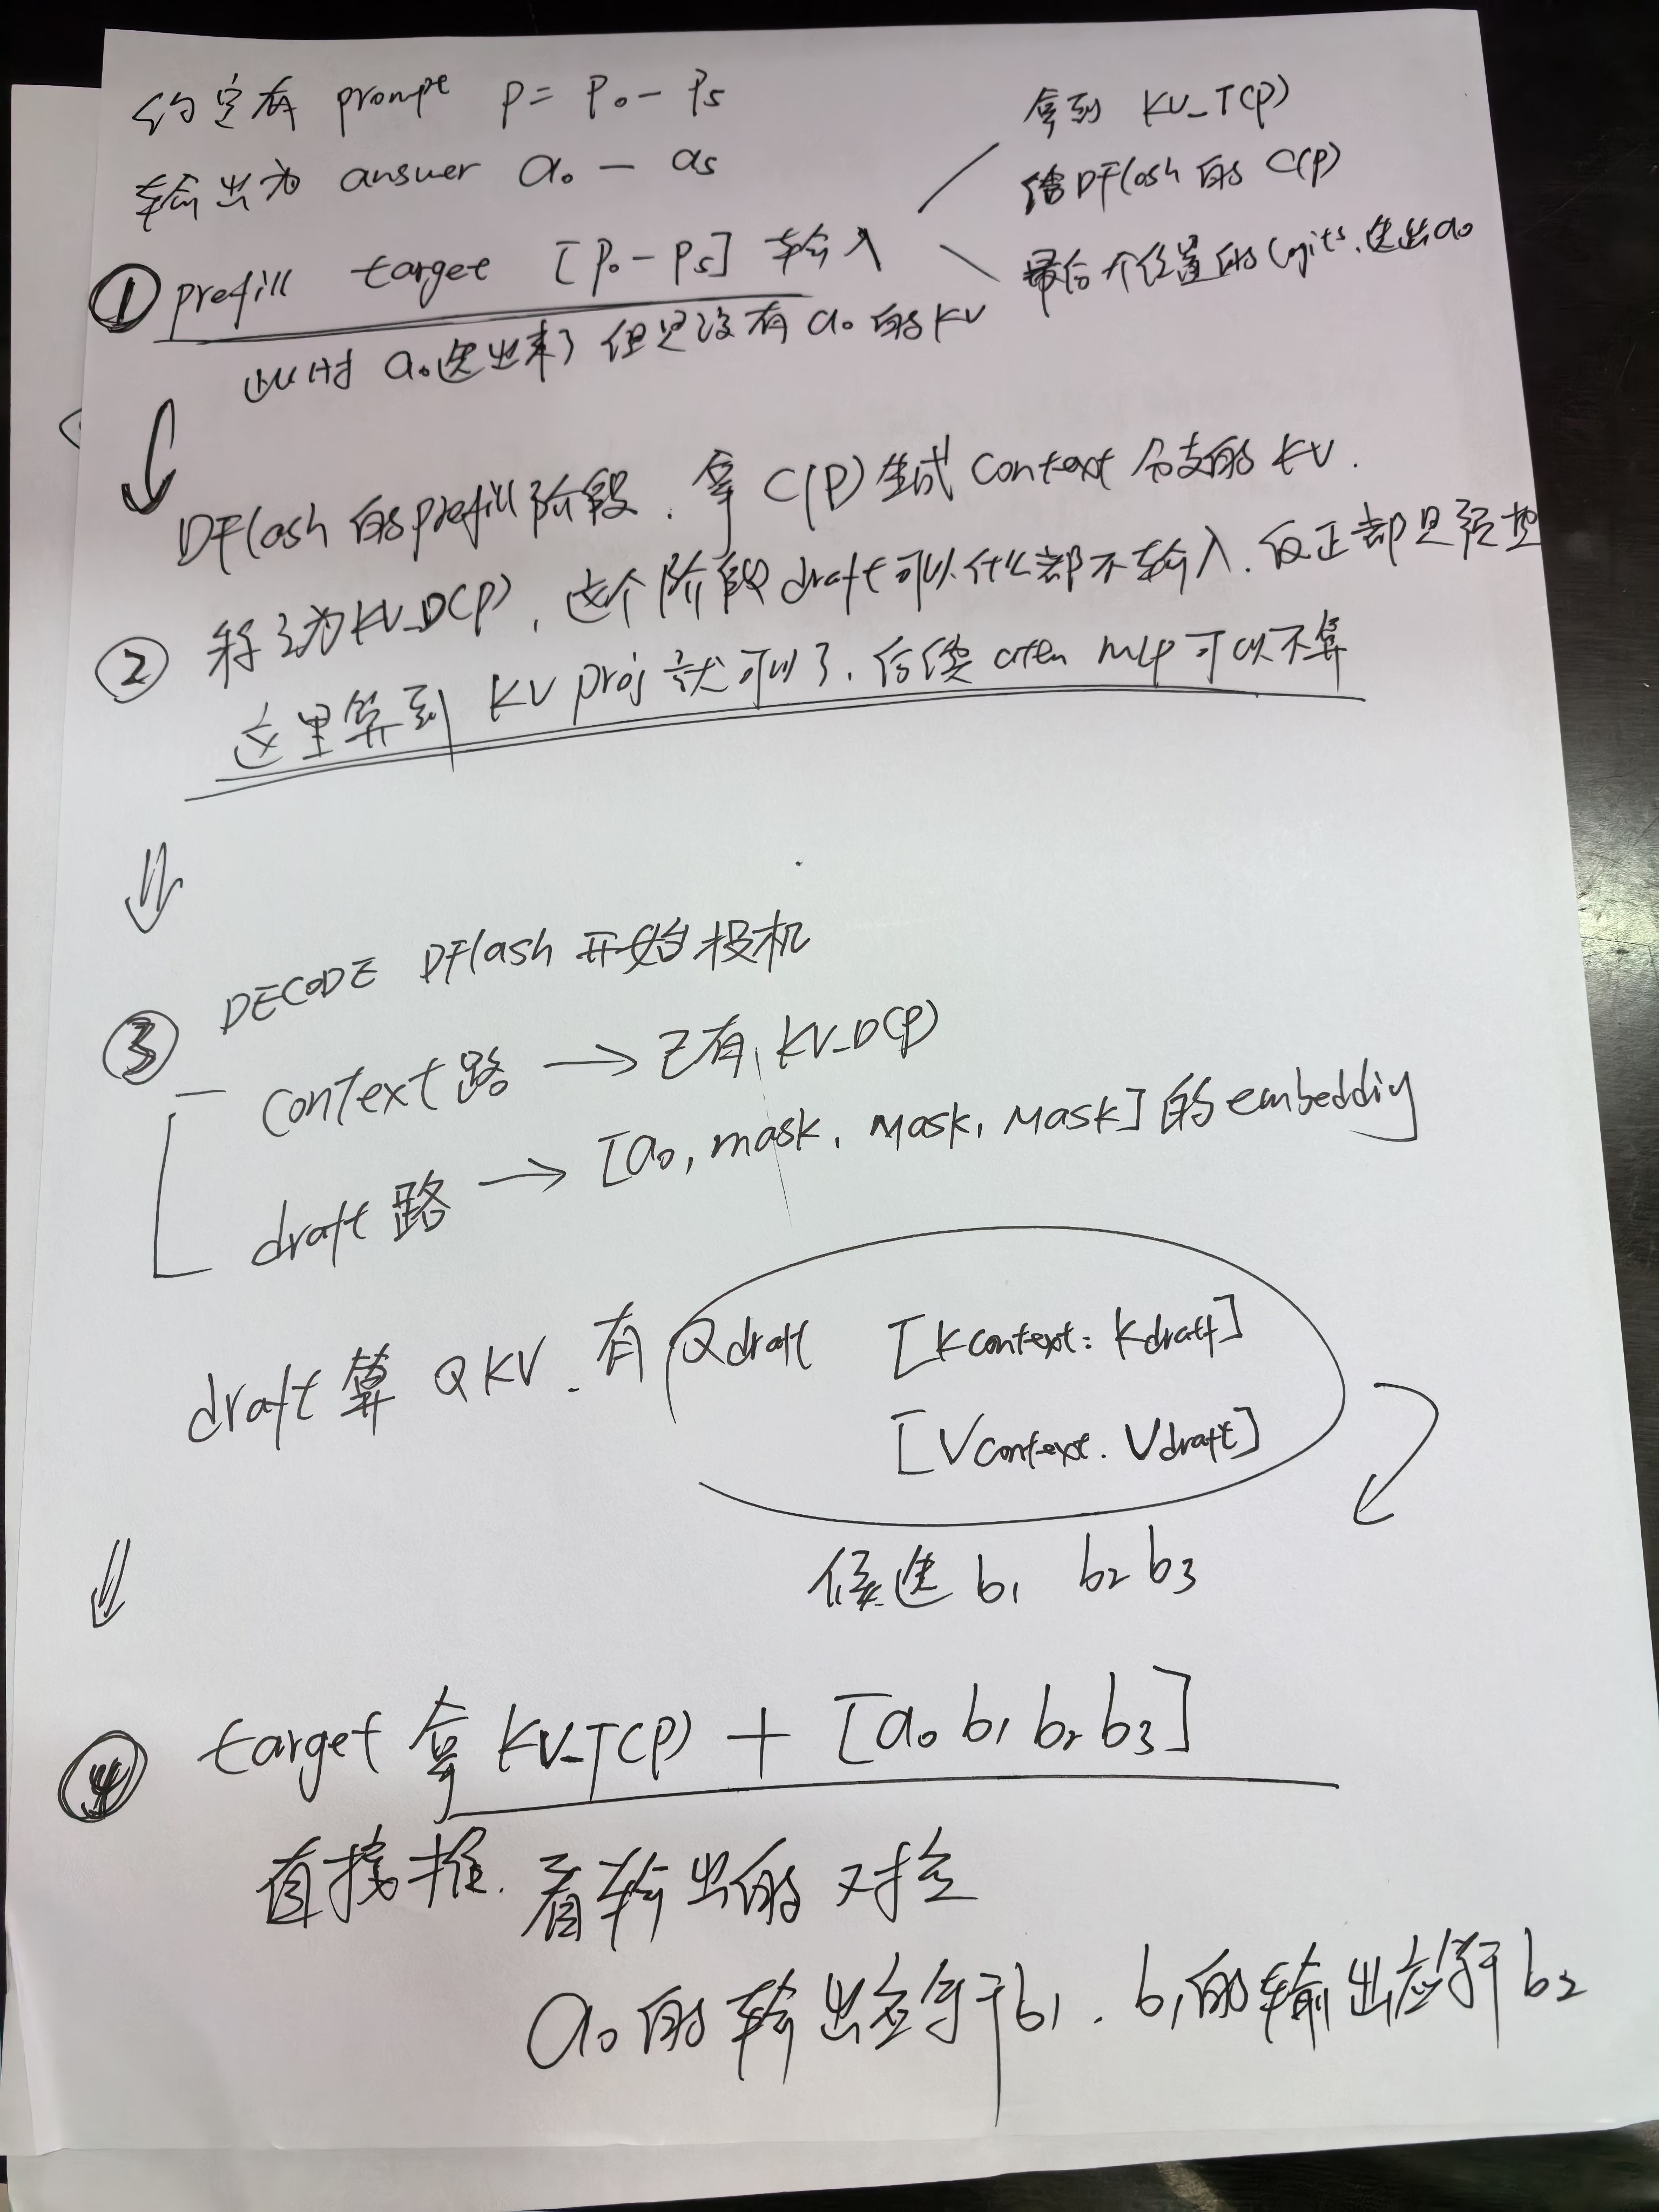
答案是:对。按完整 context 方案,第一次起草前,DFlash 要建立覆盖整个 prompt 的 context KV Cache。但它接收的不是 prompt 原文,而是 target 对 prompt 算出的 hidden states,再通过自己的 context 分支生成 KV;两者的 KV Cache 数值并不相同。DFlash 的公开设计就是用 target 的 context 特征构建自己的上下文 KV。
下面忽略多层、量化和滑窗,用 5 个 prompt token、每次起草 3 个候选来模拟。验收用贪心解码举例。
约定
P = [p0, p1, p2, p3, p4]:prompta0:target 从 prefill 最后一个 logits 选出的第一个回答 tokenKV_T(P):target 自己的 prompt KVKV_D(P):DFlash 用 target 的 prompt 特征生成的 context KV
① Prefill:target 先读完整 prompt
target 的输入:
[p0, p1, p2, p3, p4]这次前向得到三类东西:
| 结果 | 用途 |
|---|---|
| KV_T(P) | 存入 target KV Cache |
| prompt 每个位置的 hidden states,提取、融合成 C(P) | 提供给 DFlash |
| 最后一个位置的 logits | 选出 a0 |
此时 a0 已经选出来了,但还没有作为输入经过 target,因此 target Cache 里还没有 a0 的 KV。
这和普通自回归相同:预测出一个 token,与把这个 token 输入模型、算出它的 KV,是前后两步。
② Prefill 的衔接:DFlash 建立 prompt 的 context KV
DFlash 拿到覆盖 5 个位置的 C(P),走自己的 context 分支:
C(P) → context K/V 投影、K 的 Norm/RoPE 等 → KV_D(P)因此,两边都记住了完整 prompt:
| 模型 | 此时持久缓存覆盖的位置 |
|---|---|
| target | P,共 5 个位置 |
| DFlash | P,共 5 个位置 |
DFlash 在这里需要处理全部 prompt 的 context 特征,但 context 位置不需要再走一遍完整的 draft Attention、MLP、lm_head。它们负责提供 K/V,供后面的 draft 位置读取。
这个初始化可以单独做,也可以合在第一次 DFlash 起草调用里做;逻辑上都是先准备好 context KV,再供 Attention 使用。
③ Decode 第一轮:DFlash 起草
DFlash 此时拿到的两路信息是:
| 路 | 具体内容 |
|---|---|
| context 路 | 已缓存的 KV_D(P) |
| draft 路 | [a0, MASK, MASK, MASK] 的 embedding |
位置对应关系:
| 位置 | 0~4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|
| 内容 | prompt | a0 | MASK | MASK | MASK |
DFlash 为这 4 个 draft 位置计算 Q/K/V,Attention 读取:
Q_draft, [K_context; K_draft], [V_context; V_draft]一次前向后,假设三个 MASK 位置预测出:
候选:[b1, b2, b3]这次 [a0, MASK, MASK, MASK] 产生的 draft KV 都是临时数据,不作为下一轮的持久 context KV。持久 context 仍覆盖 P;后续新增 context 要来自 target 的验证特征。
④ Decode 第一轮:target 验证
target 拿到:
| 数据 | 内容 |
|---|---|
| 旧 KV Cache | KV_T(P) |
| 本次新增输入 | [a0, b1, b2, b3] |
target 不需要重新输入 prompt;它通过旧 KV 读取 prompt,并用因果 Attention 一次处理这 4 个新增位置。
各位置 logits 的用途:
| target 本次输入位置 | 对应 logits 预测什么 |
|---|---|
| a0 | a0 后面该是什么,用来检查 b1 |
| b1 | b1 后面该是什么,用来检查 b2 |
| b2 | 用来检查 b3 |
| b3 | 若三个候选全部通过,可以再选出一个 token |
假设:
- b1 通过
- b2 不通过,target 在这个位置选择了 c2
那么确认的序列变为:
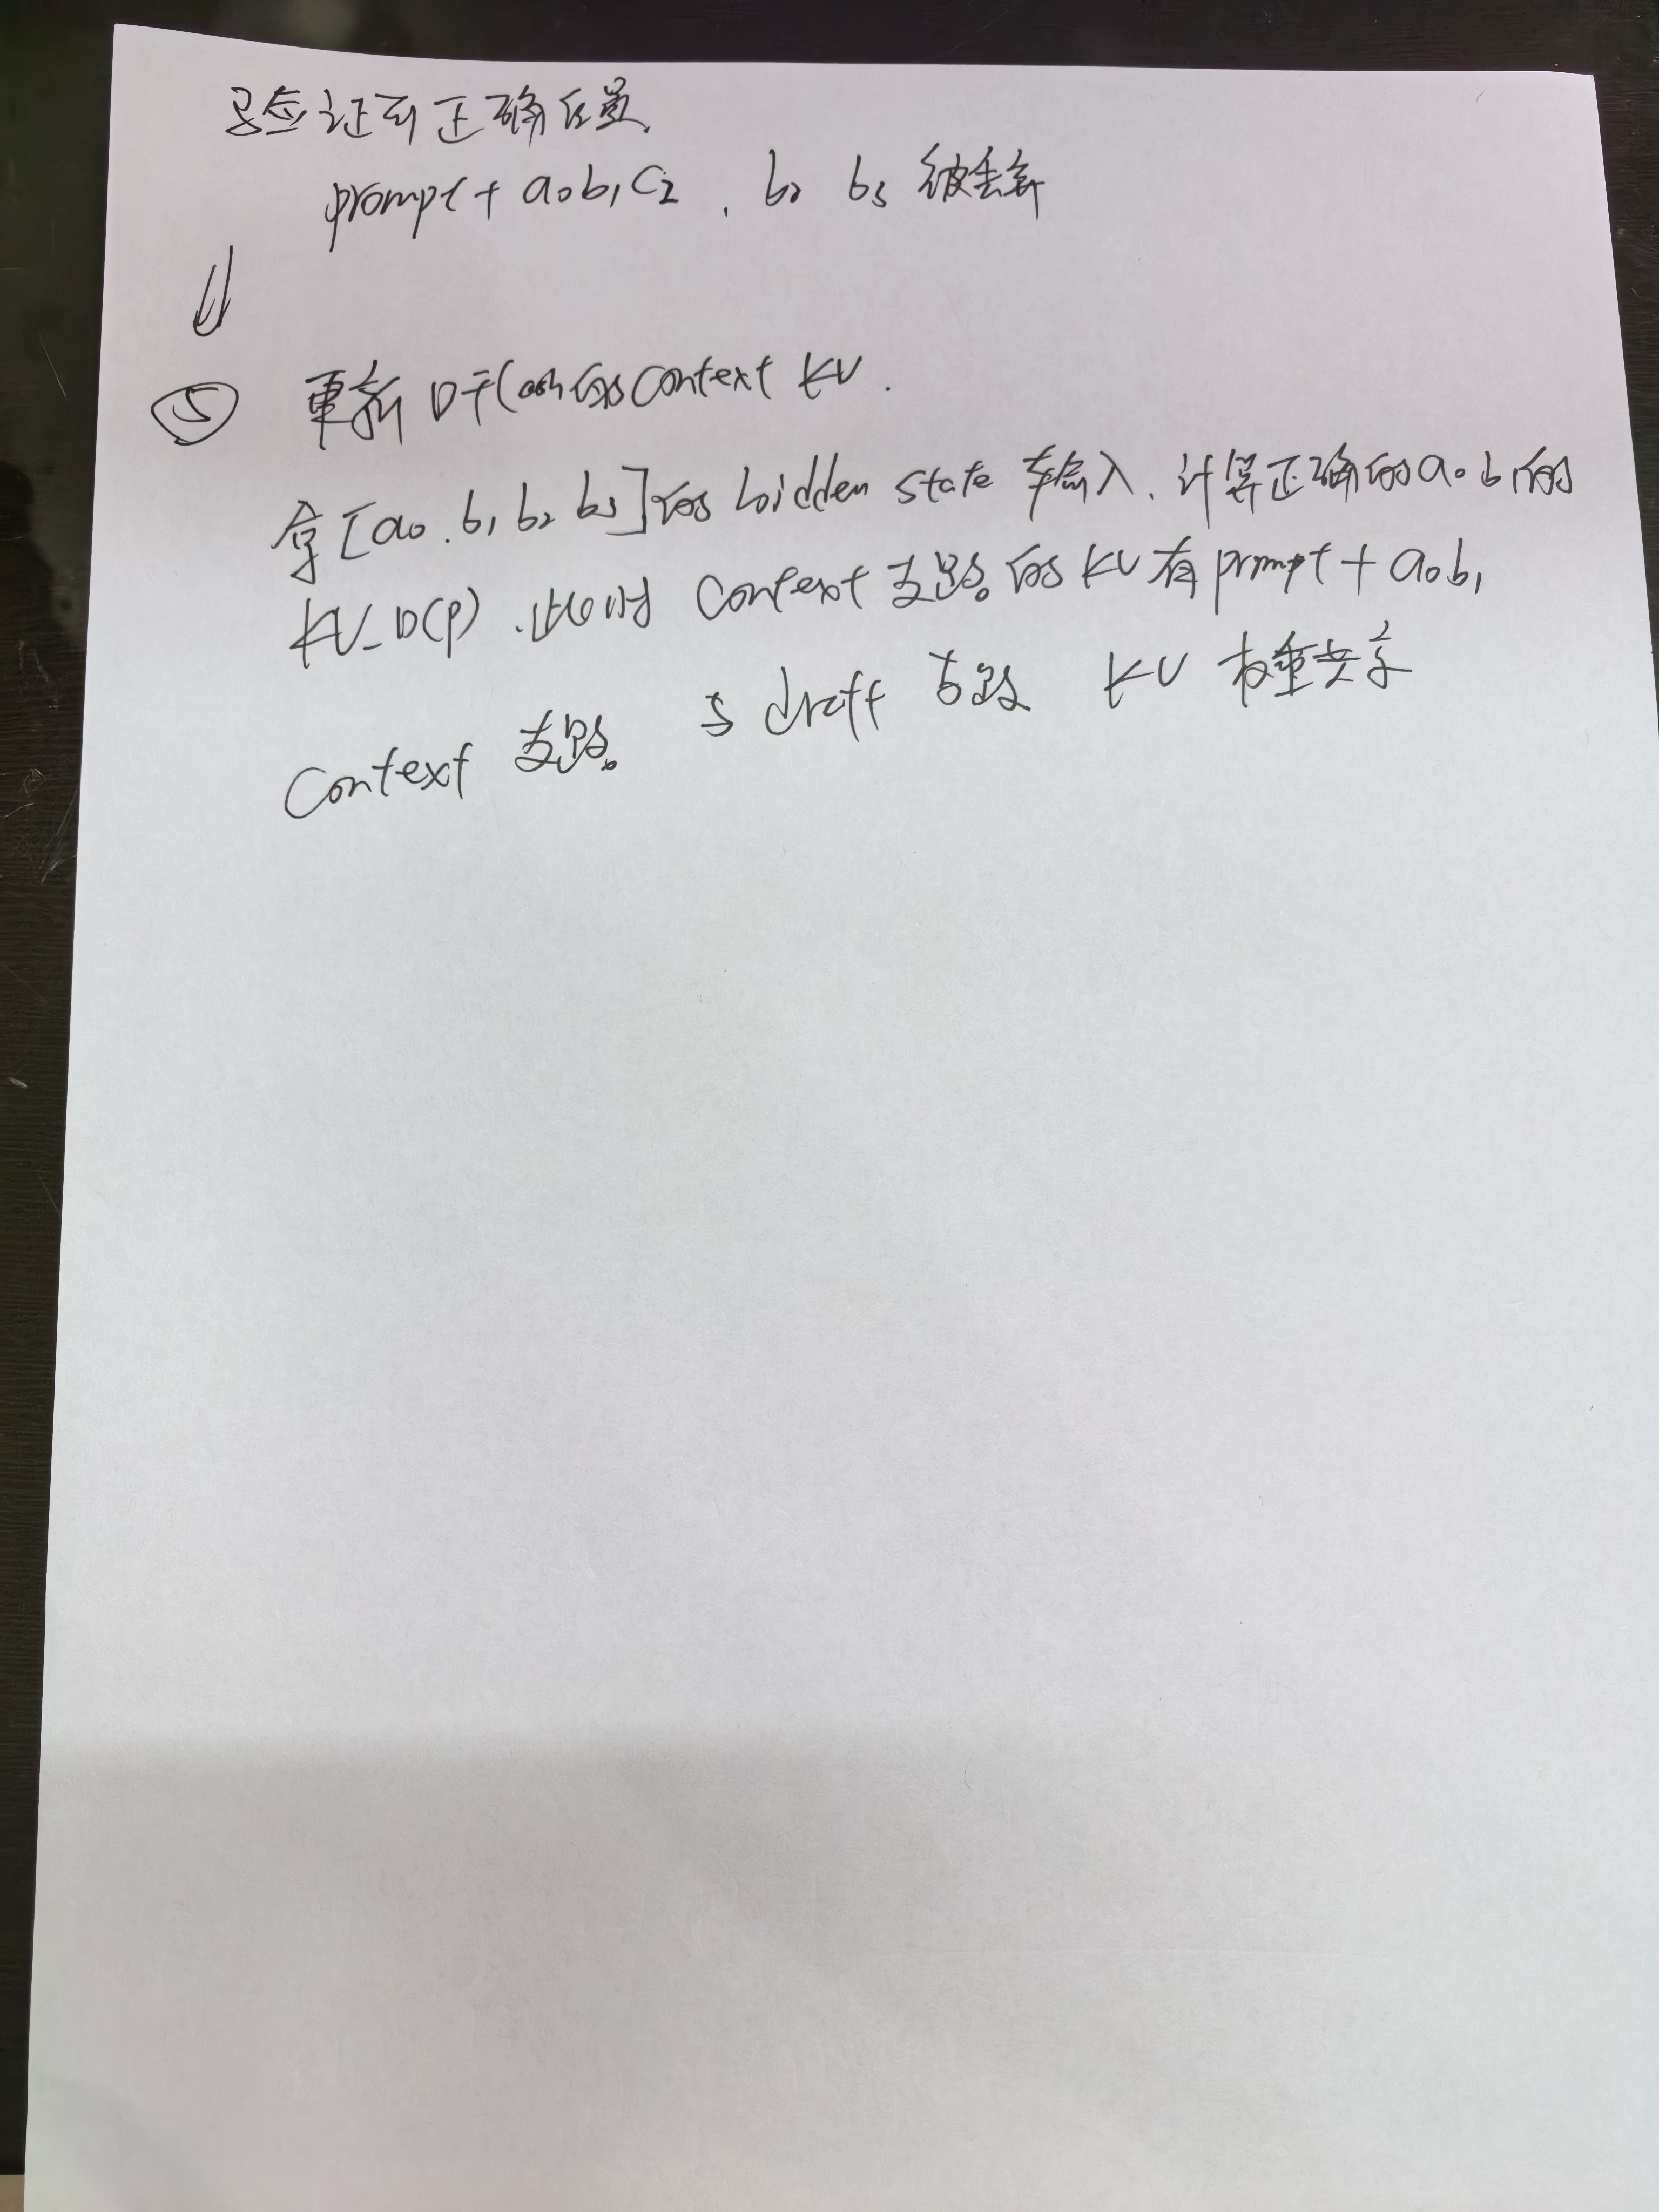
P + [a0, b1, c2]b2、b3 被丢弃。
target 验证时虽然临时算出了 [a0, b1, b2, b3] 的 KV,但只保留正确前缀:
target KV Cache = KV_T(P + [a0, b1])c2 刚从 logits 选出来,还没输入 target,所以它的 KV 暂时没有。
⑤ 更新 DFlash 的 context KV
target 验证还产生了 [a0, b1, b2, b3] 对应的 hidden states。
其中只提取正确前缀 [a0, b1] 的特征,交给 DFlash:
target 的 C(a0, b1) → DFlash context K/V 分支 → 追加到原来的 KV_D(P)更新后:
DFlash context KV Cache = KV_D(P + [a0, b1])这里追加的是 target 验证特征生成的 context KV。第一轮起草时临时生成的 a0/MASK KV 不用于这个更新。公开实现区分了 context 特征输入和 draft embedding 输入,并管理相应的缓存。
⑥ Decode 第二轮:同样的过程继续
第二轮 DFlash 的两路输入变成:
| 路 | 内容 |
|---|---|
| context 路 | KV_D(P + [a0, b1]) |
| draft 路 | [c2, MASK, MASK, MASK] 的 embedding |
注意位置:
- context:P 在位置 0~4,a0 在 5,b1 在 6
- draft:c2 在位置 7,三个 MASK 在 8、9、10
DFlash 再预测三个候选,target 再输入 [c2, 新候选们] 验证,随后两边继续更新各自缓存。
按时间压成一张表
| 时刻 | 已确认的序列 | target 持久 KV 覆盖 | DFlash 持久 context KV 覆盖 |
|---|---|---|---|
| target prefill 完成 | P + a0 | P | 尚未初始化 |
| DFlash 初始化完成 | P + a0 | P | P |
| 第一轮起草完成 | P + a0,另有待验证候选 | P | P |
| 第一轮验收、两边缓存更新完成 | P + a0 + b1 + c2 | P + a0 + b1 | P + a0 + b1 |
所以理解的方向是对的:prefill 时,DFlash 就要建立 prompt 的 context KV;decode 时,每轮只补充新确认、且已经经过 target 前向的 token 特征。最新选出的那个 token,则作为下一轮的 anchor,通过 embedding 进入 draft 路。
我的笔记
当时手写的笔记也贴在这里: